文章を書かないAI「Jev」で、1万件を10分で仕分けた

文章を書かないAIとは
2026年9月15日、TypeSafe AI が「Jev」というモデルを早期アクセスで公開しました。同社が「System One モデル」と呼ぶ種類の最初のモデルで、ChatGPT や Claude のような文章を生成するLLMとは性質が異なります。
Jev は文章を生成しません。代わりに、次の3種類の問いに、確率付きで答えます。
| 問いの型 | 答え方 | 例 |
|---|---|---|
| Choice | 選択肢から1つ選ぶ(選択肢ごとの確率と、選んだ答えへの確信度=confidence が付く) | この商品の品目は何か(18択) |
| Score | 段階で評価する | 主な買い手は企業か、両方か、消費者か |
| Noul | Yes/No の確率を返す(0〜1) | この計画は対象に当てはまるか |
1回のリクエストに複数の問いを並べると、並列で答えます。料金は入力100万トークンあたり $0.042 で、出力は無料です(2026年9月25日時点、公式ドキュメントより)。
弊社では、公開データ1万件を仕分ける実務で Jev を試しました。この記事では、その実測をもとに、LLMと何が違い、どのような仕事に向くのかを整理します。
試した題材:公開データ1万件から「自社で食品を作って売る会社」を探す
弊社は Shopify によるECサイト制作の提案先を探しています。提案先を探す元データとして使ったのは、公開されている補助金の採択一覧です。
- データ: 事業再構築補助金の採択結果(第8〜13回、製造/卸売・小売/宿泊・飲食/農業・林業の4業種)の PDF を読み取った 10,359件。1件ごとに、事業者名・業種・事業計画名(30字ほど)・概要(100字ほど)がある
- 探したもの: 消費者向けの食品・飲料・ペットフードを、自社で作って(または自社ブランドで)売る計画
1件ごとに、次の4問をまとめて Jev に聞きました。
- 対象に当てはまるか(Noul)
- 主力商品の品目は何か(Choice・18択)
- 健康食品・化粧品か(Noul・除外に使う)
- 主な買い手は誰か(Score・3段階)
精度を測るため、300件に正解ラベルを付けました(無作為に選んだ200件と、食品に関する語を含む行から選んだ100件)。なお、この正解ラベルは Claude(AI)が Jev の出力を見る前に付けたもので、人は確認していません。判断に迷う39件には「境界ケース」の印を付けています。
実施日は2026年9月25日、モデルは jev-1.13.0(当日 jev-latest が指していた版)です。
結果:キーワードで絞るよりも取りこぼしが少ない
当初は「EC」「直販」などのキーワードで絞る想定でした。無作為200件(うち本当の対象30件)で、キーワードと Jev を比べた結果が次の表です。
表の適合率は「拾ったもののうち何割が本当の対象か」、再現率は「本当の対象のうち何割を拾えたか」です。F1 は適合率と再現率を合わせた指標で、両方が高いほど1に近づきます。
| 方式 | 適合率 | 再現率 | F1 |
|---|---|---|---|
| キーワード(食品語 かつ「EC・直販・販路開拓・ブランド・通販・オンライン」) | 1.00 | 0.13 | 0.24 |
| キーワード(食品語だけ) | 0.53 | 0.77 | 0.63 |
| Jev(英語で質問・最初の版) | 0.85 | 0.97 | 0.91 |
| Jev(日本語で質問・最初の版) | 1.00 | 0.90 | 0.95 |
| Jev(英語で質問・除外条件を直した版) | 0.97 | 0.93 | 0.95 |
| 同上(境界ケースを除く186件) | 1.00 | 1.00 | 1.00 |
キーワード(食品語かつEC)は、拾ったものはすべて正解でしたが、本当の対象の87%を落としていました。対象となる会社の多くは、計画に「EC」とは書いていなかったためです。
なお、「除外条件を直した版」は、評価に使ったのと同じ300件を見ながら質問を直しています。そのため、この版の数字には評価データへの合わせ込みが含まれます。未知のデータでの精度は、評価データを見ずに作った最初の版(英語 F1 0.91、日本語 F1 0.95)を目安にしてください。
確率はどれくらい当たるか
Jev を使う利点は、答えに確率が付くことです。その確率がどの程度当たるのかを、300件(英語・直した版)で確かめました。この版は同じ300件を見て直しているため、確率の当たり方にも合わせ込みが含まれます。
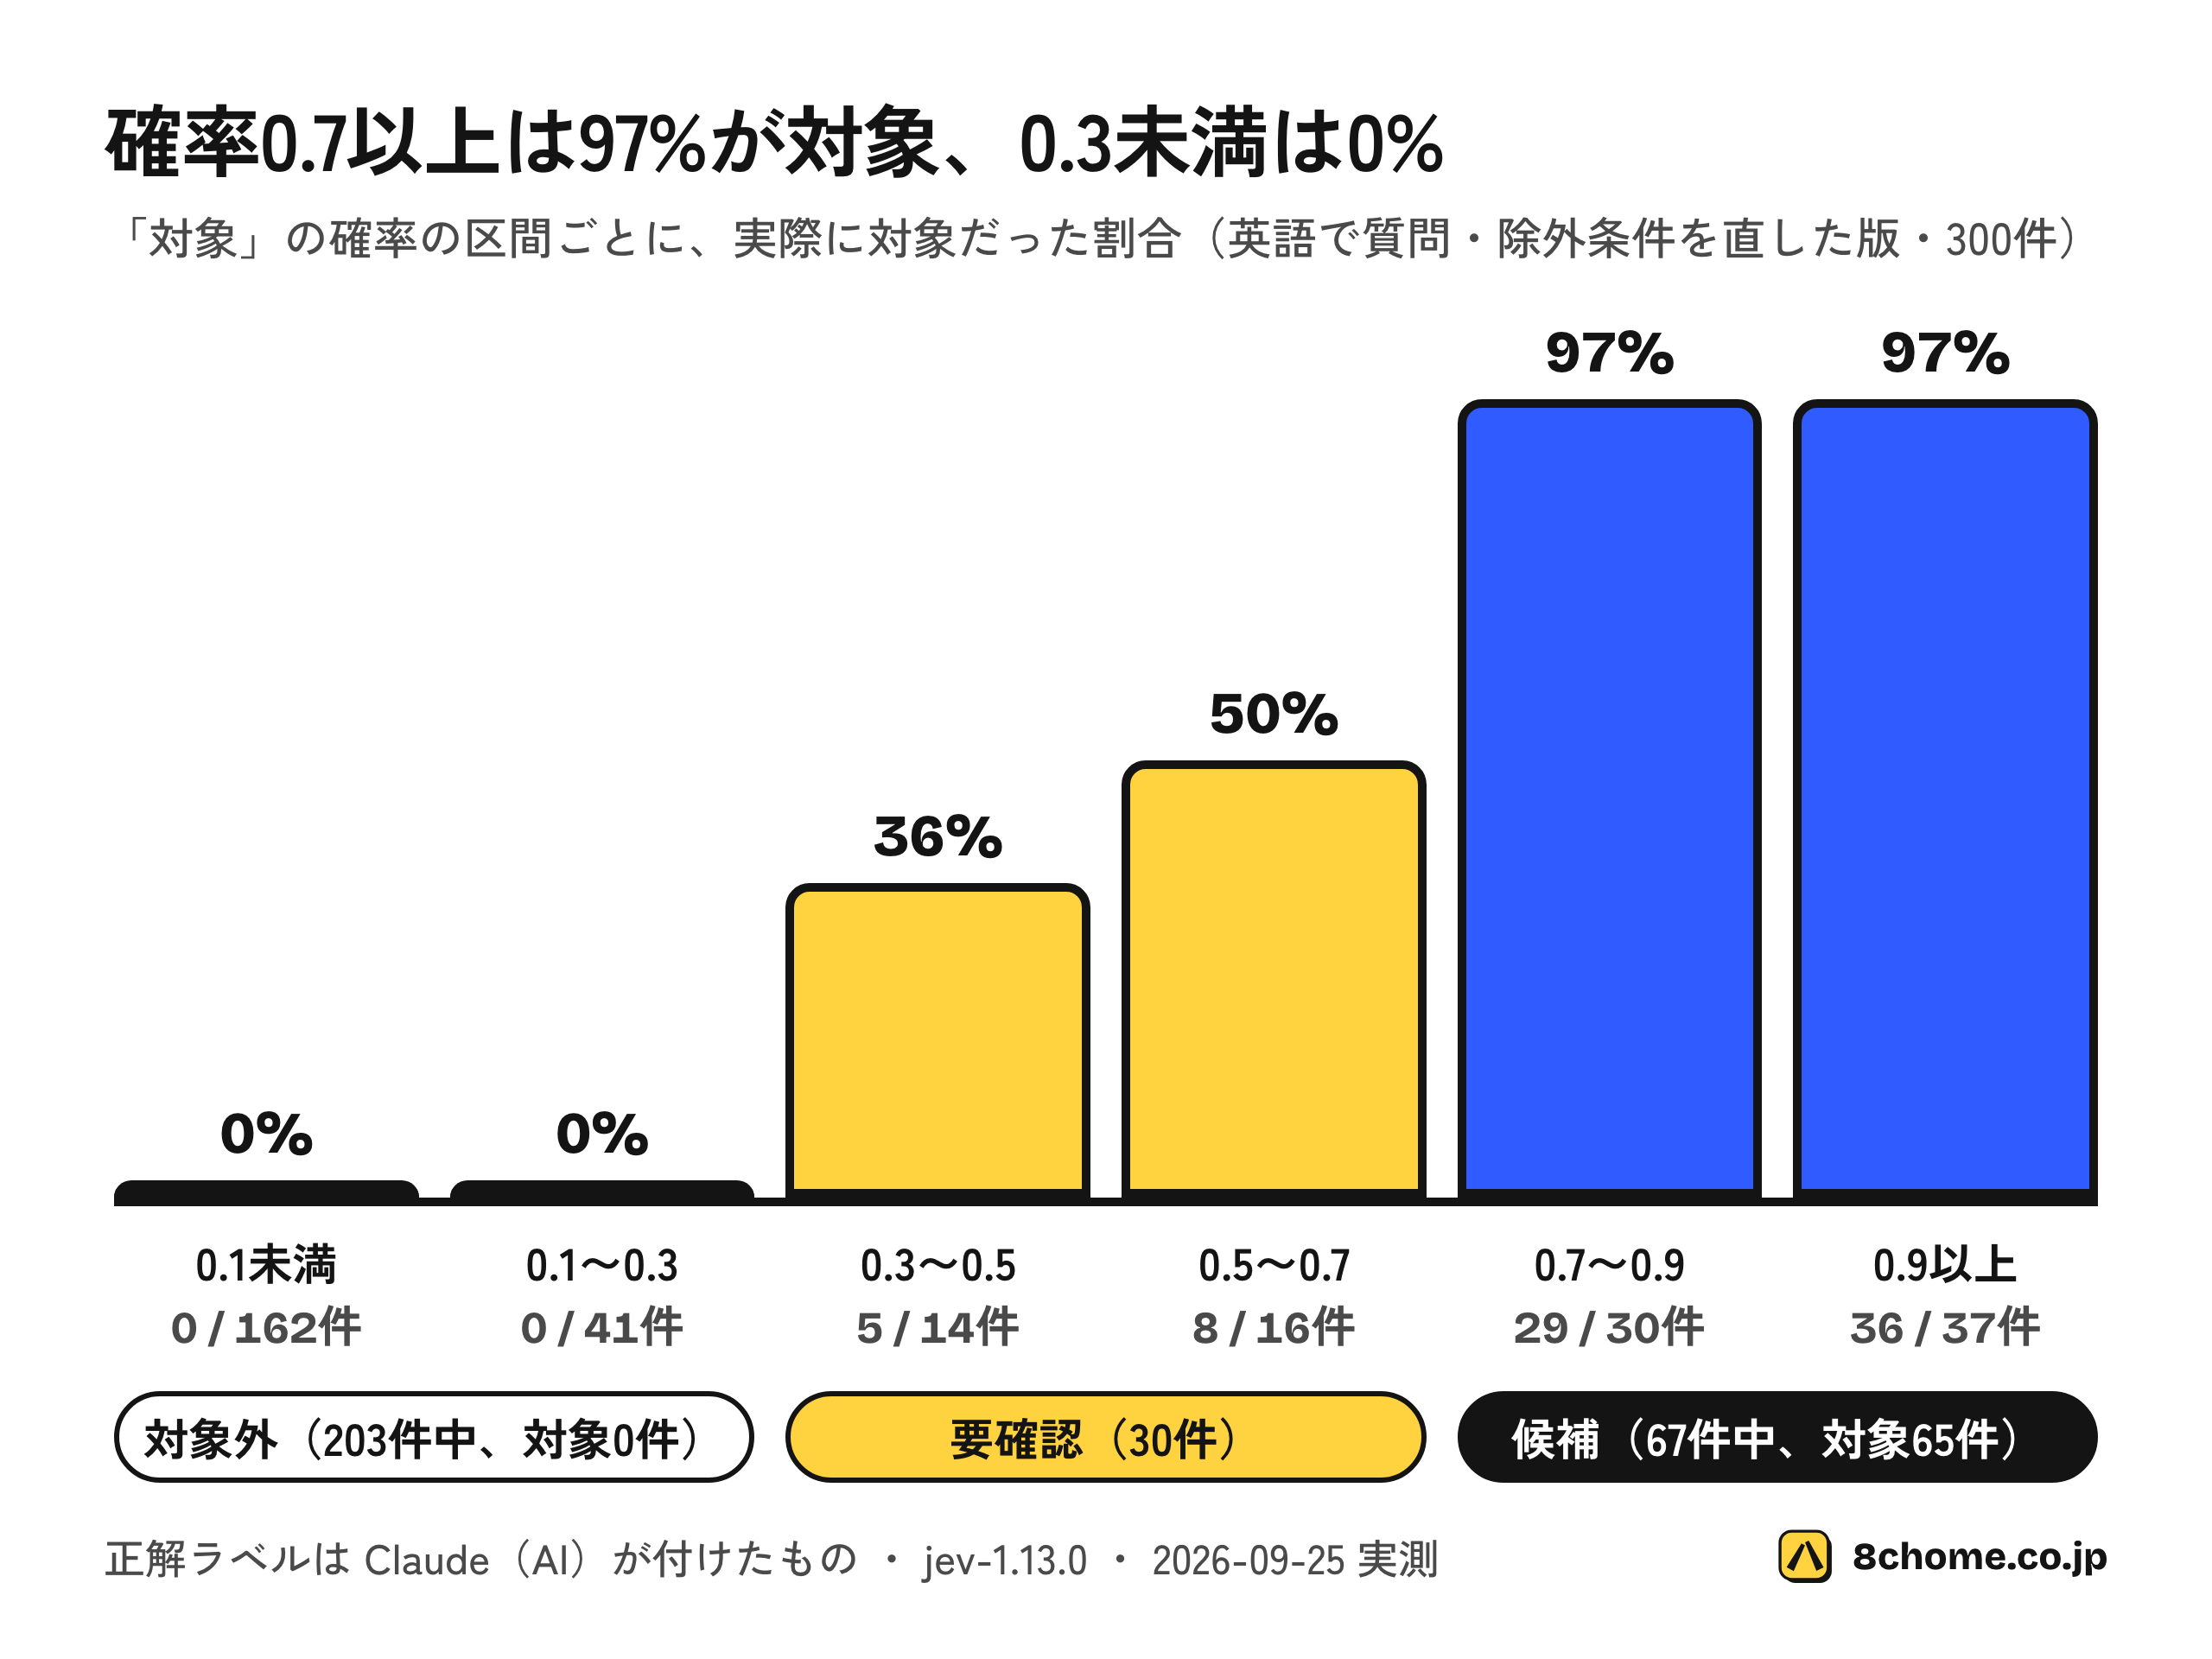
| 「対象」の確率 | 0.1未満 | 0.1〜0.3 | 0.3〜0.5 | 0.5〜0.7 | 0.7〜0.9 | 0.9以上 |
|---|---|---|---|---|---|---|
| 本当の対象だった件数/区間の件数 | 0/162 | 0/41 | 5/14 | 8/16 | 29/30 | 36/37 |
確率0.7以上の67件は65件が本当の対象で、0.3未満の203件には本当の対象が1件もありませんでした。この300件では、確率0.3〜0.7の30件を人が確認すれば、0.3未満を確認しなくても取りこぼしは出ませんでした。
ほかの問いの結果は次のとおりです。
- 品目: confidence 0.9以上の答えは62件すべて正解(外したものは、すべて0.9未満)
- 健康食品・化粧品: 取りこぼし0件(10件中10件を検出)、誤検出2件
- 主な買い手: 対象の78件中72件が一致
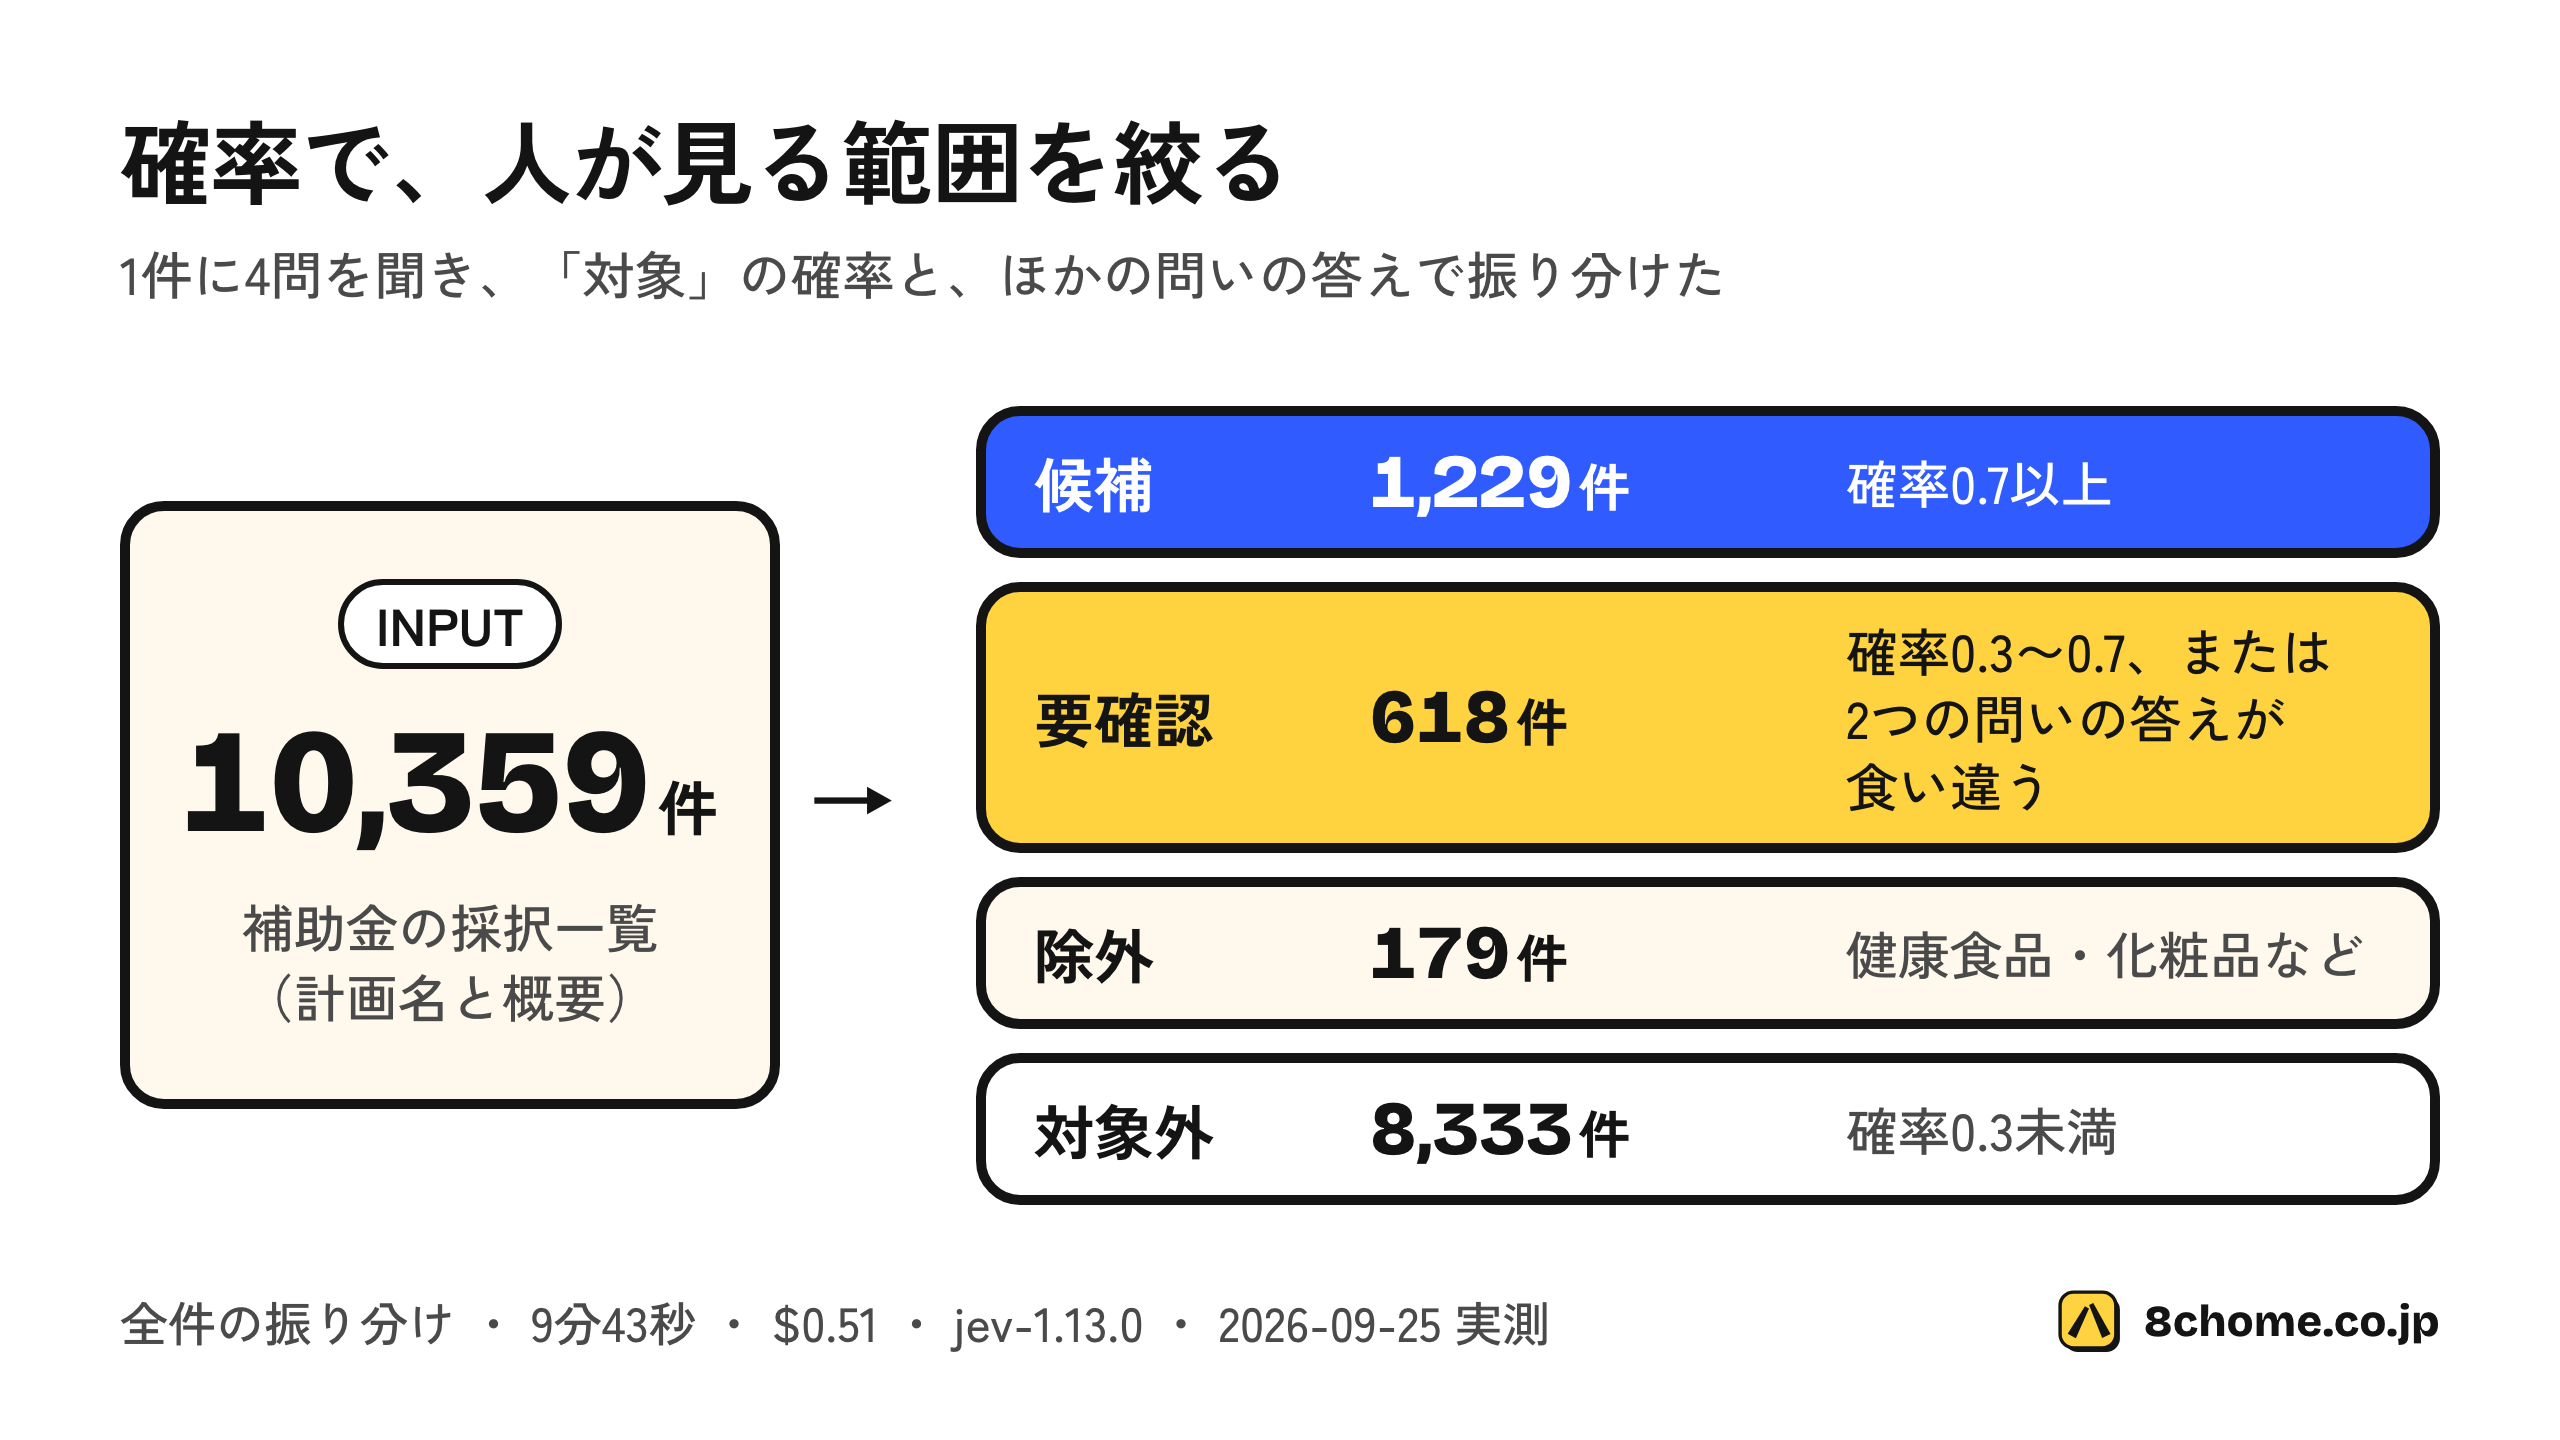
この結果をもとに、全10,359件を「候補(0.7以上)」「要確認(0.3〜0.7)」「除外(健康食品など)」「対象外(0.3未満)」の4つに振り分けました。
この振り分けの考え方そのものは、別の記事で詳しく扱う予定です。
速さと費用
- 全10,359件を9分43秒で処理しました(同時に4リクエスト、毎分約1,070件。1件=1リクエストで、レート制限の毎分1,200リクエストの範囲内)
- 入力は合計1,214万トークンで、費用は $0.51でした
- 1リクエスト(4問)の応答時間は、中央値0.22秒、95パーセンタイル(100回のうち95回はこの時間以内)0.26秒
- 1件あたりの入力は、英語の質問で約1,180トークン、日本語の質問で約1,350トークン
- 後から問いを2つ足し、候補1,229件だけに聞き直した際は、69秒・$0.03でした
問いを足して聞き直す費用が小さいため、「まず全件を粗く仕分け、候補にだけ細かい問いを追加する」という進め方が取りやすくなります。
使って分かった3つの癖
1. 条件を文字どおりに読む。除外したい業態は列挙すると改善した
最初の版では、除外条件を「飲食店・カフェ・ホテルで料理を提供するだけのもの」としていました。すると Jev は、キッチンカー・デリバリー・カフェの計画を対象として拾いました。「自分で作った食べ物を消費者に売っている」という条件に、文字どおりには当てはまるためです。
そこで、除外条件(Noul の false 側の説明)を次のように1行変えました。
変更前: meals served only at a restaurant, cafe or hotel
変更後: restaurant, cafe, bar, hotel, food truck or delivery businesses
        that serve freshly cooked meals, even for take-out
この変更で、英語の質問の F1 が0.91から0.95に上がりました。公式ドキュメントも、苦手なこととして最初に「文字どおりに読む」を挙げています(Jev 1.13 の苦手)。除外したいものは、抽象的に書かず具体的に列挙するのが有効でした。
2. 日本語で質問しても精度は下がらず、確率が低めに出た
公式は「英語が主で、日本語などの CJK は英語ほどの精度が出ない。自分のデータで試してから使うこと」としています。今回のデータ(本文は日本語)では、日本語の質問(最初の版)の F1 は0.95で、英語の質問(最初の版0.91、除外条件を直した版0.95)と比べて低くはなりませんでした。
違いが出たのは確率の出方です。日本語の質問では確率が低めに出ました。「対象」と判定する確率の境目(閾値)を、同じ再現率0.94が得られる値で比べると、英語の質問で0.5、日本語の質問で0.3でした。
公式も、適切な閾値は用途とモデルの性能によって決まるとしています。弊社は、質問の文面や言語を変えるたびに閾値を測り直すことにしています。
3. 問い同士の答えが食い違うことがある
「対象」の確率が0.7以上なのに、品目の問いでは「食品以外」と答えたものが19件ありました。中身はダイエットアプリやドッグランなどで、ほとんどは「対象」の問いの誤りでした。
Jev は、関連する問い同士の答えが整合することを保証していません(公式の苦手の一覧にも含まれています)。そこで、2つの問いの答えが食い違ったら人の確認に回すルールを、振り分けのコードに入れました。
文章を生成するLLMとの使い分け
費用の概算
同じ10,359件を、文章を生成するLLM(Claude)で処理した場合の費用を見積もりました。LLMでは実際には処理していないため、あくまで概算です。1件あたり入力1,180トークン・出力80トークンと仮定しています(Claude と Jev ではトークンの数え方が異なるので、目安です)。幅は、Batch API(料金が半額になる代わりに、結果が後から返る)を使うかどうかの違いです。表中の料金は、100万トークンあたりの入力/出力の単価です。
| 1万件の費用 | Jev の何倍か | |
|---|---|---|
| Jev(実測) | $0.51 | — |
| Claude Haiku 4.5($1/$5) | $8〜16 | 16〜32倍 |
| Claude Sonnet 5($2/$10) | $16〜33 | 32〜64倍 |
| Claude Opus 5.5($4/$20) | $33〜65 | 64〜128倍 |
Claude の料金は2026年9月25日時点の公式料金ページによります。
ただし、1回きりの処理であれば、$0.51 と $8〜16 の差は、選ぶ決め手になりにくいと考えています。費用の差が効いてくるのは、毎日処理する、数十万件ある、質問を直して何度も回す、といった場合です。
決め手は、答えが正しい確率が付くこと
弊社が Jev を使う一番の理由と考えているのは、安さよりも、答えごとに「それが正しい確率」が付くことです。
Claude の API は、答えの確率を返しません。OpenAI などはトークンごとの確率(logprobs)を返せますが、それを「選択肢ごとの当たる確率」として使うには工夫が要ります。LLMに「自信は何%か」を答えさせる方法もありますが、その数字が実際の正解率と一致する保証はありません。なお、今回はLLMの自己申告がどの程度当たるかは測っていないため、ここは一般論として書いています。
LLMの方が向いている場面
一方で、次のような場面では、文章を生成するLLMの方が適しています。
- 判断が込み入る(条件の組み合わせ、数や日付の計算、判断理由の説明が要る)
- 文章を書く(営業メールの文面など)
- 件数が少ない(数百件なら Claude Haiku 4.5 でも費用は数十セントで、プロンプトを書く手間の方が大きい)
- 安定性が求められる(Jev は早期アクセスで、レート制限も需要に応じて変わるとされている)
まとめると、件数が多く、言葉の意味で判断でき、迷うものを人に回せる仕事であれば、Jev はLLMよりも安く処理でき(費用は概算)、確率を使って人が確認する範囲を絞れます。
始め方
API キーは TypeSafe のコンソールで発行します。弊社は $5 のクレジットで始め、1万件を処理しても $0.51 でした。
今回は HTTP API を Python から直接呼びました。1件分のリクエストは次の形です(公式の Python SDK typesafe-sdk もあります)。
import json, os, urllib.request

body = {
    "model": "jev-1.13.0",
    "state": {"plan_title": "…", "plan_summary": "…"},
    "questions": {
        "target": {
            "type": "noul",
            "instructions": "Under this plan, will the business sell food products "
                            "it makes itself to ordinary consumers?",
            "criteria": {"true": "…", "false": "…"},
        },
    },
}
req = urllib.request.Request(
    "https://api.typesafe.ai/v1/systemone",
    data=json.dumps(body).encode(),
    headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}",
             "Content-Type": "application/json"},
)
res = json.load(urllib.request.urlopen(req))
print(res["answers"]["target"]["noul"])  # 0〜1 の確率
モデル名は jev-latest ではなく版を固定して指定しています。jev-latest の指す版が変わると確率の出方も変わり、測った閾値が使えなくなるためです。
注意点
今回の結果を読むうえで、次の点に留意してください。
- 正解ラベルは Claude(AI)が付けたもので、人は確認していません
- 文章を生成するLLMとは、精度を直接比べていません(費用の比較も概算です)
- 除外条件を直した版は、評価に使ったのと同じ300件を見て直しています
- 1つのデータセットで1回処理した結果です。他のデータや質問で同じ精度が出るとは限りません
- Jev は早期アクセスの製品で、仕様・レート制限・料金が変わる可能性があります。今回の実測は
jev-1.13.0によるものです
新しいAIは、自社のデータで試してから決める
新しいモデルが出るたびに、ベンダーは速さや精度を発表します。Jev の公式ブログでも応答速度などが紹介されていますが、それが御社の業務データで同じように出るかは、試してみるまで分かりません。今回も、日本語での確率の出方や、除外条件の書き方への反応は、実データで試して初めて分かりました。
株式会社八丁目では、新しいAIを実際の業務データで試し、どの仕事に使い、どの仕事には使わないかまで決めたうえで導入を提案しています。
関連記事
 最初のAIはどれ? ChatGPT・Gemini・Claude の選び方(2026年)AIを今から入れる少人数の会社向けに、ChatGPT・Gemini・Claudeの違いを2026年7月時点の料金と使い勝手から整理。『どこから入るか × 何が得意か』で選ぶ考え方を、実際に主要AIを使っている立場から紹介します。記事を読む →
 「全部AIに任せる」は失敗する。うまくいく「分担」の型AI導入がうまくいくかは能力差ではなく「分担の設計」の差でした。AIは事前準備と段取り、人は判断・承認・関係づくり——弊社が営業・経理・タスク・コンテンツの4業務でどこに線を引いているかを具体的に公開します。記事を読む →
大量のデータの仕分けや、AIに任せる範囲と人が確認する範囲の設計について、お気軽にお問い合わせフォームからどうぞ。